multidimenzionální databázový model a olap
OLTP a OLAP, typy OLAP. Datový sklad, datová kostka, dimenze, tabulka faktů. Hvězda a vločka. CUBE, ROLLUP, ALL.
1 OLTP a OLAP
OLTP (Online Transaction Processing) systémy slouží pro uchovávání běžných provozních informací, jsou optimalizovány pro současný přístup velkého množství uživatelů, běžných zaměstnanců firmy. Po OLTP systémech se požaduje se vysoký výkon a okamžitá dostupnost informací. OLTP systémy bývají v dnešní době implementovány pomocí relačních databázových systémů, mezi které patří například SQL Server. Příkladem OLTP systému může být nám dobře známá databáze Northwind.
Transakce v OLTP systémech jsou obvykle jednoduché a krátké, nejčastěji spočívají v přidávání nových řádků tabulek, méně často provádějí modifikaci existujících řádek tabulek. V OLTP systémech se může provádět i čtení dat, vyhledávání informací o konkrétních proběhlých transakcích, vyhledáváním podle hodnot některých sloupců v jedné tabulce či ve spojení několika málo tabulek.
Informace uchovávané v OLTP systémech jsou velmi detailní (například: zákazník X koupil dne Y zboží Z v obchodě W). Data bývají obvykle normalizovaná ve 3 NF. Rychlost přírůstku dat je vysoká, jejich velké množství zpomaluje práci se systémem a snižuje okamžitou dostupnost dat. Z těchto důvodů se obvykle starší transakční data (například starší než 1 rok nebo 5 let) maží z aktuálních tabulek. Mazané informace z OLTP jsou navíc uchovány v datovém skladu.
OLAP (Online Analytical Processing) systémy se snaží uspořádat velké objemy historických dat tak, aby data byla přístupná a srozumitelná vybrané skupině uživatelů (analytici, manažeři), zabývajících se složitější analýzou dat za účelem vyhodnocení obchodních výsledků a vyhledávání trendů. Uživatelé neprovádějí aktualizaci dat, pouze je čtou. Dotazy pokládané OLAP systémům bývají často velmi komplikované, k jejich vyhodnocení je potřeba spojení velkého množství tabulek. Klasickým příklad dotazu je zobrazení prodeje zboží podle sledovaných dimenzí (například čas, místo, výrobek, zákazník).
OLAP uživatele zajímají data v agregované podobě (například dne Y se v obchodě W prodalo Q kusů zboží Z), nezajímají je jednotlivé konkrétní transakce. Data není nutno držet ve 3NF, naopak nenormalizovaná data umožňují snadnější tvorbu dotazů, protože pro dotazy postačí spojení menšího počtu tabulek.
OLAP systémy mohou být implementovány pomocí relačních databázových systému (ROLAP), nebo multidimenzionálních technologií (MOLAP), nebo jejich kombinací, hybridním přístupem (HOLAP).
Při ROLAP způsobu uložení dat vytvoříme v relační databázi nové tabulky, které budou obsahovat agregovaná data. Tento způsob uložení dat se hodí pro velmi rozsáhlá data, která nejsou příliš často analyzována.
Při MOLAP způsobu uložení dat využíváme technologii, která je přímo optimalizována pro multidimenzionální dotazy. Data jsou ukládána na OLAP serveru. Optimalizace spočívá v předpočítávání výsledků možných dotazů a jejich ukládání na disk, což pro rozsáhlá data může být neúnosné. MOLAP je výhodný pro menší až střední objemy dat, která často analyzujeme. Tento způsob uložení dat je využit například v rozšíření databázového systému Oracle pro OLAP.
HOLAP je kompromisní řešení, využívající výhod obou přístupů. Původní data jsou ponechává v relační databází, ale agregované hodnoty jsou ukládány pomocí multidimenzionální technologie.
1.1 Datový sklad
Datový sklad, někdy bývá označován zkratkami DW a DWH (Data Warehouse), slouží k uchovávání historických dat. Datový sklad je většinu času v pracovním režimu, ve kterém se data nemění a dochází pouze k jejich čtení pro potřeby OLAP. Periodicky jednou za stanovený časový úsek (například den, měsíc či rok) přibude nová dávka dat z OLTP a dochází k aktualizaci datového skladu, dochází k zápisu dat Během aktualizace je odepřen čtecí přístup OLAP uživatelům.
Datový sklad obecně může získávat data z více zdrojů, které nemusí být pouze relačními databázemi. Data mohou být v jednotlivých zdrojích uloženy v různých formátech, mohou obsahovat chyby, duplicity. Samotná čištění dat je rozsáhlé vědní odvětví využívající pro svoji práci velké množství heuristik. Data bývají integrována podle vzájemných vazeb, bez ohledu na zdroj, ze kterého pocházejí. Data jsou organizována tak, aby šlo co nejsnadněji vytvářet OLAP dotazy.
V běžném OLTP systému se při návrhu indexu musíme zajímat o poměr využití tohoto indexu při dotazech vzhledem k počtu aktualizačních operací, při kterých se index mění. Pokud je index využívám při dotazech málo, jeho existence může dokonce zhoršit plynulost práce s databází. V datovém skladu se data téměř nemění (pouze občasně hromadně přibývají), proto nedochází ani k častým změnám indexů. Naopak typickou prácí V OLAP systémech je dotazování, proto se v datovém skladu indexují všechny sloupce, jejichž hodnoty bychom v dotazech mohli použít v podmínce.
Pokud aktualizace datového skladu je rozsáhlá (přibývá třeba desetina nových dat), může být výhodné indexy dočasně odstranit. Na začátku aktualizace datového skladu se všechny indexy zruší (příkazem DROP INDEX) a jako poslední krok aktualizace se opět vytvoří.
1.2 Datová kostka
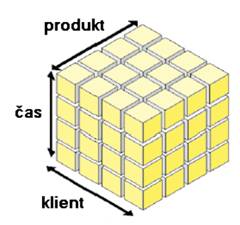
Datové sklady a OLAP využívají multidimenzionální datový model, který zobrazuje data ve formě datové kostky. Datovou kostku si lze představit jako n-dimenzionální tabulku, ve kterém jednotlivé dimenze kostky reprezentují vlastnosti dat. Na prvním obrázku jsou zobrazeny 1, 2 a 3 dimenzionální datové kostky. V praxi se používají i vyšší dimenze (10-20), ale jejich grafické znázornění je obtížné. Další příklad trojdimenzionální datové kostky vidíme na druhém obrázku. V tomto příkladu je na ose x klient, na ose y čas nákupu, a na ose z produkt. Jednotlivé prvky tabulky (na obrázku ty malé krychličky), reprezentují nějakou agregovanou hodnotu (například počet prodaných kusů, tržby, náklady) pro kombinaci příslušných dimenzí (například: dne Y se v obchodě W prodalo Q kusů zboží Z).
Jednotlivé dimenze můžou být navíc uspořádány do hierarchií. V případě času se může jednat o přesné datum, dvojice měsíc a rok, nebo samotný rok. Hodnoty v dimenzi hierarchicky nadřazené se získají sečtením hodnot v příslušném úseku podřízené dimenze. Například prodeje v daném roce se získají sečtením prodejů v měsících daného roku.
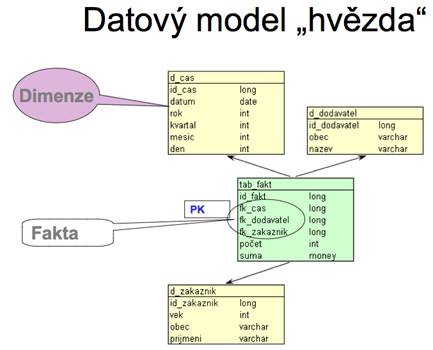
Datový model se skládá ze dvou typů tabulek: faktů a dimenzí (viz obrázek). Jedna tabulka faktů a k ní příslušné tabulky dimenzí odpovídají schématu OLAP. V tabulce faktů jsou sloupci cizí klíče jednotlivých dimenzí a sloupec s agregovanou hodnotou (například počet prodejů). Tabulky faktů jsou ve 3 NF. Tabulky dimenzí obsahují sloupce specifikující vlastností souřadnic pro danou dimenze. Rozlišujeme dva typy datových modelů: hvězda a vločka.
V datovém modelu vločka (obrázek) jsou tabulky dimenzí ve 3NF, pro jednu dimenzi může existovat více tabulek. Při použití tohoto schématu zkomplikujeme vytvoření a vyhodnocení dotazů, protože bude docházek k častému spojován tabulek v rámci jednotlivých dimenzí.
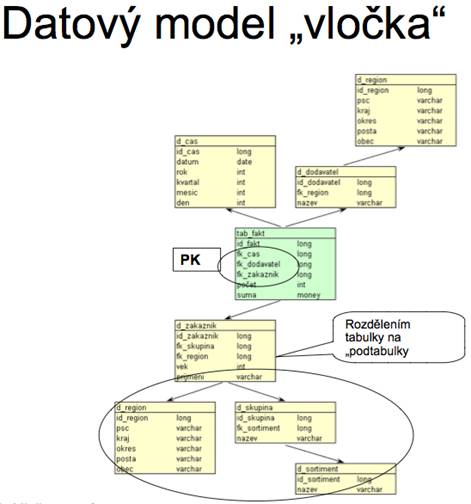
V datovém modelu hvězda tabulky nejsou ve 3 NF, pro každou dimenzi je jen jedna tabulka. Vytváření dotazů je pohodlnější a jejich vyhodnocování rychlejší než v případě schématu vločka. Nenormalizované tabulky dimenzí obsahují redundantní data, mohl by nastat problém při jejich aktualizaci, mohou zabírat také více místa na disku. Vzhledem k poměru velikosti tabulek dimenzí ku velikosti tabulky faktů, jsou tyto problémy zanedbatelné.
2 OLAP dotazy pomocí SQL
SQL příkaz SELECT s využitím klauzule GROUP BY umožňuje zodpovědět celou řadu dotazů, které by mohly zajímat OLAP uživatele. Několik dotazů, které by šly vyřešit příkazem SELECT s použitím klauzule GROUP BY:
· Kolik utratil každý zákazník v každém měsíci za zboží z každé skupiny?
· Kolik celkem v každé skupině?
· Kolik celkem v každém měsíci?
· Kolik celkem utratil každý zákazník?
· Kolik utratili všichni dohromady?
· Kolik kdy utratil zákazník „Franta Vopršálek“ za elektroniku?
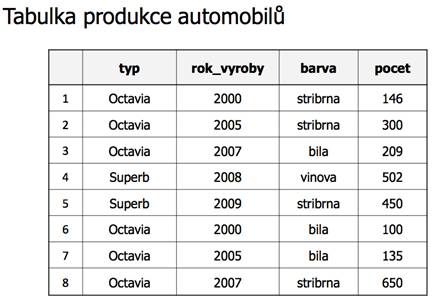
Na obrázku vidíme tabulku, kterou budeme používat v následujícím motivačním příkladu. V tabulce (jménem Auta) máme sloupce typ automobilu, rok výroby, barva a počet prodaných kusů. Tato tabulka je již agregována, aby šla přehledně zobrazit. Můžeme si však představit původní tabulku, kde budou zaznamenány prodeje konkrétních automobilů s dodatečnými sloupci (například zákazník, datum prodeje). Každý řádek naší tabulky by se v původní tabulce opakoval (s různými hodnotami dodatečných sloupců) tolikrát, kolik je hodnota atributu počet prodaných kusů v naší tabulce.
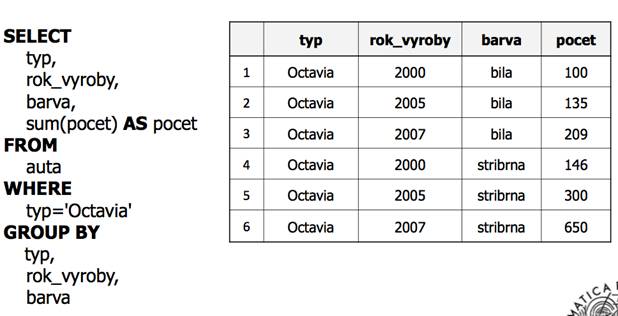
Na dalším obrázku vidíme SQL dotaz (s klauzulí WHERE) zjišťující počty prodaných aut typu Octavia pro konkrétní kombinace roku výroby a barvy auta. Napravo na slajdu vidíme výsledek dotazu, obsahující 6 řádků. Problém tohoto dotazu je jeho přílišná jednoúčelovost (jedná se o jednodimenzionální řez datové kostky). Pokud by nás zajímaly počty prodaných Octavíí v roce 2000, bez rozlišení barvy auta, museli bychom dotaz přepsat, nebo ručně sečíst hodnoty prodejů z roku 2000 pro všechny barvy (bílá, stříbrná).
Pomocí sjednocení (UNION) výsledků několika jednoduchých dotazů lze vytvořit kompletní datovou kostku. V případě tří dimenzí, musíme provést sjednocení osmi (= 23) jednoduchých dotazů. Vytváření datové kostky pomocí sjednocování jednoduchých SQL dotazů je značně nepohodlné pro programátora a jeho zpracování databázovým systémem je neefektivní. Pro vytvoření datové kostky o N dimenzích je potřeba sjednotit 2N jednoduchých dotazů obsahujících klauzuli GROUP BY. Zpracování takovéhoto dotazu je výpočetně náročné, velké množství dat se počítá zbytečně opakovaně v různých jednoduchých dotazech. Jako provizorní řešení pro malé tabulky a malý počet dimenzí je to však použitelné. Lepším řešením je použití operátoru CUBE.
2.1 operátor CUBE
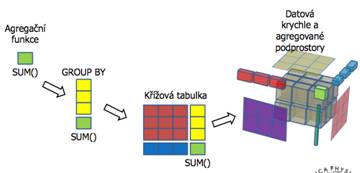
Operátor CUBE doplňuje klauzuli GROUP BY v příkazu SELECT tak, že při jeho použití je místo jednodimenzionálního řezu vytvořena celá datová kostka. Sloupce uvedené v klauzuli GROUP BY odpovídají dimenzím. V klauzuli SELECT jsou tyto sloupce zopakovány a bývá zde alespoň jeden další sloupec, který je tvořen hodnotou agregační funkce (například počet prodaných výrobků).
Přesná syntax operátoru CUBE záleží na konkrétním databázovém systému.
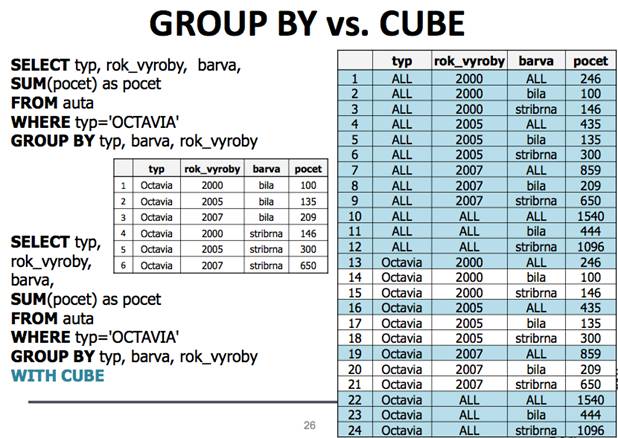
„SELECT typ, rok_vyroby, barva , SUM(pocet) AS pocet FROM auta WHERE typ='OCTAVIA' GROUP BY typ, rok_vyroby, barva WITH CUBE“ je syntax používaná v SQL Serveru 2005, za seznam sloupců v klauzuli GROUP BY se přidají klíčová slova WITH CUBE.
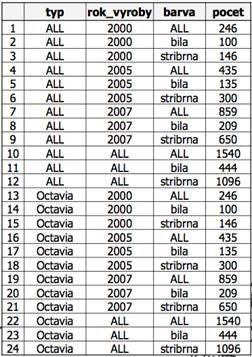
Uvedeným příkladem zjišťujeme datovou kostku pro počty prodaných aut pro dimenze typ auta, roku výroby a barva. Přehled je omezen na auta typu Octavia. Na obrázku je zobrazen výsledek. Ve výsledku je pro hodnoty některých sloupců použito klíčové slovo ALL, které udává, že hodnoty v daném sloupci jsou agregovány.
Na následujícím obrázku vidíme dva dotazy. V horním dotazu provádíme jednodimenzionální řez datovou kostkou pomocí klauzule HAVING. Výsledkem dotazu je 6 řádků, které vidíme dole pod dotazem. V dotazu dole na slajdu je vytvořena datová kostka za pomocí operátoru CUBE, výsledek dotazu je zobrazen v pravé části slajdu. Bíle označené řádky jsou shodné s řádky z prvního (horního) dotazu. Modře označené řádky jsou nové oproti prvnímu dotazu.
2.2 operátor ROLLUP
Výpočet celé datové kostky pomocí operátoru CUBE je časově náročný a někdy nechceme využít ani všechna data, která takto získáme. Operátor ROLLUP považuje pořadí sloupců uvedených v klauzuli GROUP BY za hierarchii, sloupec uvedený více vlevo je v hierarchii výše. Operátor ROLLUP provádí agregaci pouze směrem ze shora dolů v rámci této hierarchie.
Stejně jako v případě operátoru CUBE, přesná syntaxe operátoru ROLLUP záleží na konkrétním databázovém systému. V SQL Serveru 2005 se za seznam sloupců v klauzuli GROUP BY přidají klíčová slova WITH ROLLUP. Na většině ostatních databázových serverů se přidává klíčové slovo ROLLUP těsně za GROUP BY, před uvedením seznamu sloupců.
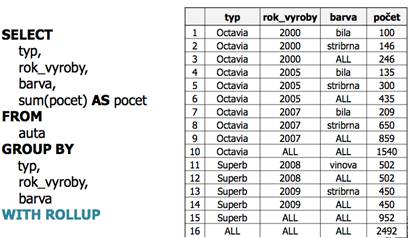
Na obrázku vidíme příklad použití operátoru ROLLUP. Hierarchie sloupců (1. typ automobilu, 2. rok výroby, 3. barva) je dána pořadím jejích zápisu v klauzuli GROUP BY. Výsledek dotazu obsahuje 16 řádek a je zobrazen napravo na slajdu. Po bližším prohlédnutí výsledku dotazu můžeme vypozorovat pravidlo pro výskyt ALL. Pro jednoduchost předpokládejme, že pořadí sloupců v klauzuli SELECT je shodné s pořadím sloupců v klauzuli GROUP BY, jako je tomu v našem případě. Pokud se je pro nějaký řádek hodnota nějakého sloupce ALL, poté všechny sloupce napravo do tohoto sloupce (s výjimkou sloupce udávajícího hodnotu agregační funkce) mají také hodnotu ALL.
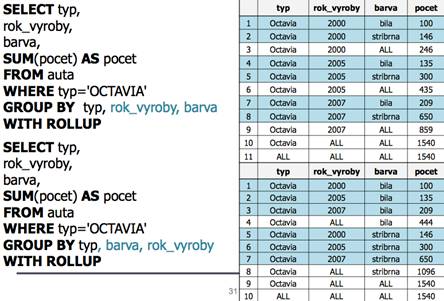
Na dalším obrázku vidíme dva velmi podobné dotazy používající operátor ROLLUP. Dotazy se liší pouze v pořadí sloupců v klauzuli GROUP BY: V prvním (horním) dotazu je pořadí sloupců typ automobilu, rok výroby a barva auta, ve druhém (spodním dotazu) je prohozen druhý a třetí sloupec, výsledné pořadí je typ automobilu, rok výroby a barva auta. Výsledky obou dotazů jsou znázorněny napravo na slajdu. Modře označených šest řádků je shodných v obou dotazech a získali bychom je dotazem obsahujícím pouze klauzuli GROUP BY bez použití operátoru ROLLUP. Ve výsledku druhého dotazu nás možná překvapí řádky č. 4 a 8, které na první pohled porušují pravidlo pro výskyt ALL vysvětlené v předchozím odstavci. O chybu se nejedná, pro použití pravidla nebyl splněn předpoklad, že pořadí sloupců v klauzulích SELECT a HAVING je shodné.
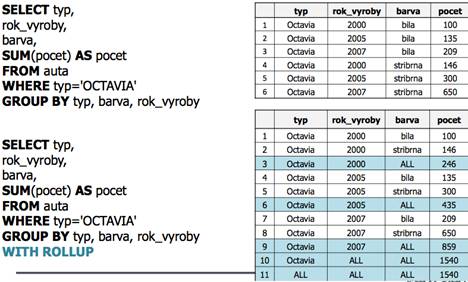
Níže se nacházejí dva dotazy, demonstrující rozdíly mezi GROUP BY bez použití operátoru ROLLUP (první, horní dotaz) a s jeho použitím (druhý, dolní dotaz). Výsledky obou dotazů jsou znázorněny v pravé části slajdu. Bíle označené řádky jsou patří do výsledku obou dotazů, modře označené řádky získáme pouze druhým dotazem.
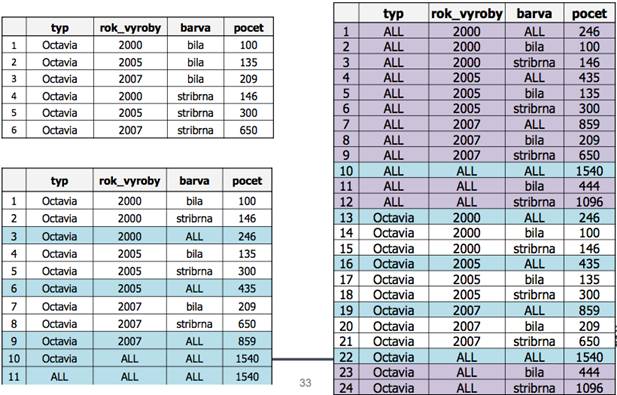
Na posledním obrázku vidíme porovnání výsledků tří dotazů. První (levý horní) dotaz obsahuje pouze klauzuli HAVING, druhý (levý dolní) dotaz obsahuje operátor ROLLUP a třetí (pravý) dotaz obsahuje operátor CUBE. Řádky, které mají všechny tři výsledky dotazů společné jsou označeny bíle. Řádky společné pro výsledky druhého a třetího dotaz jsou označeny modře. Řádky obsažené pouze ve výsledku třetího dotazu jsou označeny fialově.