xml a dtd
XML, element, značka, atribut. Správně formovaný dokument, správně uzávorkovaný dokument, validní dokument. DTD, zápis elementu, a atributu, CDATA, ID, IDREF, IDREFS, entita (znaková, obecná, interní, externí, parametrická).
1 XML
XML (Extensible Markup Language) je značkovací jazyk sloužící pro popis, uchovávání a přenos dat v lidsky čitelném formátu. Množina značek není pevně dána, pro každý dokument může být definována vlastní. Jazyk XML je podmnožinou komplexnějšího jazyka SGML. XML se nezabývá způsobem, jak data zobrazit. Data lze prohlížet jako zdrojové kódy. Pomocí transformačního jazyka XSLT lze XML dokument převést na jiný formát, například HTML.
Základní stavební jednotka XML je element. Element se skládá z počáteční značky (= tagu), těla a koncové značky. Počáteční a koncová značka jsou uzavřeny ve špičatých závorkách a obsahují stejný identifikátor, který se označuje jako název elementu. Koncová značka navíc obsahuje lomítko, které je umístěno za levou špičatou závorku. V těle elementu se může vyskytovat text, jiné vnořené elementy, kombinace obojího, nebo element může být prázdný. Element může obsahovat atributy a jejich hodnoty, které se píší do počáteční značky.
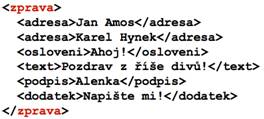
Zanořování elementů je zobrazeno na obrázku níže. V elementu zpráva se nacházejí vnořené elementy adresa (tento element se nachází dvakrát za sebou), oslovení, text, podpis a dodatek.
XML dokument musí obsahovat úvodní deklaraci (= prolog) obsahující údaje o verzi normy XML použité pro tvorbu dokumentu. Příklady několika úvodních deklarací:
· <?xml version="1.1"?>
· <?xml version="1.1" encoding="iso-8859-2"?>
· <?xml version="1.1" standalone="yes"?>
Úvodní deklarace může obsahovat další údaje, například název kódování, ve kterém je XML dokument napsán. Obvykle se používá kódování UTF-8, které obsahuje znaky všech běžných i exotických abeced (včetně indiánských obrázkových písem). Znakům jsou přiřazeny proměnlivé délky (1-6 bytů). Při použití kódování UTF-8 se informace o použitém kódování z úvodní deklarace vynechává. Pokud pracujeme pouze v českém národním prostředí, lze použít kódování windows-1250 (na Windows) nebo iso-8859-2 (na Unixu)
XML dokument se nazývá správně formovaným (= well-formed) pokud obsahuje úvodní XML deklaraci a je správně uzávorkován. Správně uzávorkovaný dokument je:
(1) Uzavřen v jediném kořenovém elementu.
(2) Každý jeho element obsahuje počáteční i koncovou značku.
(3) Identifikátory v počáteční i koncové značce jsou shodné (včetně velikosti písmen).
(4) Dvojice značek se nekříží. Dodržují správné uzávorkování, koncová značka vnořeného elementu následuje dříve něž koncová značka rodičovského elementu. Například <osoba><adresa></osoba></adresa> toto pravidlo porušuje, protože vnořený element adresa má svoji koncovou značku za koncovou značkou svého rodiče osoba.
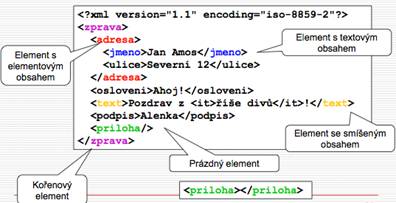
Na obrázku vidíme příklad jednoduchého XML dokumentu. V úvodní deklaraci zjistíme verzi použité normy XML a kódování dokumentu. V dokumentu je jediný kořenový element zpráva. Element adresa obsahuje dva jiné elementy, element jméno má textový obsah. V elementu text je kombinace textového a elementového obsahu, element má smíšený obsah. Element příloha je prázdný, zápis <příloha/> je zkráceným zápisem pro zápis <příloha><příloha>. Dokument je dobře formovaný.
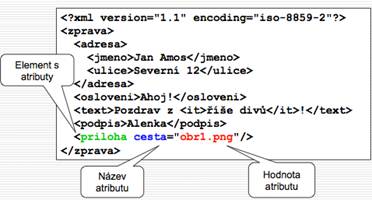
Elementy mohou mít své atributy. Atributy elementu se zapisují do počáteční značky mezi název elementu a zavírací špičatou závorku. Pokud element obsahuje atributů více, jsou navzájem odděleny mezerou. Za názvem atributu následuje znaménko = a do uvozovek "" uzavřená hodnota atributu. Na dalším obrázku vidíme u prázdného elementu příloha atribut cesta s hodnotou obr1.png.
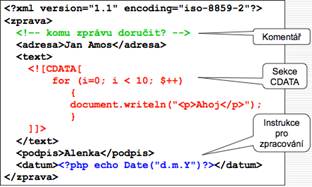
Níže je ukázka dalších prvků, které se mohou nalézat v XML dokumentu. Komentáře (označené zeleně) se uzavírají mezi <-- a -->. Pokud textový obsah elementu obsahuje znaky, které by se mohly interpretovat jako části syntaktických zápisů v XML, můžeme tento obsah uzavřít do sekce CDATA (červeně označeno). Instrukce pro zpracování se uzavírají do <? a ?>, Ihned po <? začíná název (obvykle skriptovacího) jazyka, který je následován zdrojovým kódem v daném jazyce (modře označeno).
2 DTD
Jazyk DTD (Document Type Definition) slouží k popisu struktury XML dokumentu. DTD definuje gramatiku dokumentu, která obsahuje pravidla (regulární výrazy) popisující množinu značek, které může daný XML dokument používat a omezuje obsah těchto značek.
DTD je historicky nejstarším jazyk sloužící k popisu struktury XML dokumentu. V současné době existují silnější jazyky (umožňující definovat více podrobností). Mezi tyto jazyky patří například XML Schema nebo Relax NG.
Validní XML dokument je správně formovaná dokument, který odpovídá své gramatice dané DTD, nebo jinými jazyky pro popis struktury dokumentu. Program, který rozhodne, zda dokument je validní, se nazývá validátor.
DTD může být součástí validního XML dokumentu, ale může být také v samostatném souboru. V XML dokumentu je pak pouze odkaz na toto DTD. Na obrázku vidíme tři příklady. Na prvním z nich je DTD součásti XML dokumentu. Na druhém příkladu se soubor s DTD nachází ve stejném adresáři jako XML dokument a v XML dokumentu je uvedena k němu pouze cesta. Ve třetím příkladu je v XML dokumentu uvedena cesta k DTD dokumentu umístěném na internetu.
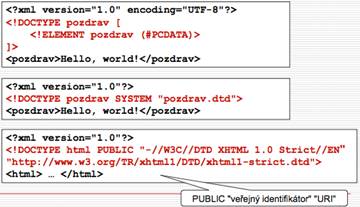
V DTD se jednotlivé značky uzavírají mezi <! a !>. Základní přehled značek:
· Deklarace typu dokumentu <!DOCTYPE ... >
· Deklarace typu elementu <!ELEMENT ... >
· Deklarace seznamu atributů <!ATTLIST ... >
· Deklarace entity <!ENTITY ... >
· Deklarace notace <!NOTATION ... >
DTD začíná značkou DOCTYPE, po které následuje název DTD a hranaté závorky, vevnitř kterých mohou být použity ostatní značky ELEMENT, ATTLIST, ENTITY a NOTATION.
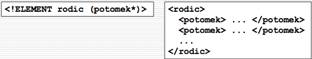
Příklad použití značky ELEMENT. Značka definuje element a jeho přípustný obsah. V našem příkladu zápis <!ELEMENT rodic (potomek*)> znamená, že element rodič smí obsahovat libovolně mnoho elementů potomek.
Deklarace typu elementu:
· Prázdný obsah <!ELEMENT priloha EMPTY>
· Libovolný obsah <!ELEMENT kontejner ANY>
· Textový obsah <!ELEMENT prijmeni (#PCDATA)>
· Smíšený obsah <!ELEMENT text (#PCDATA|it)*>
· Elementový obsah <!ELEMENT zprava (adresa,text)>
Pomocí klíčového slova EMPTY definujeme prázdný element. Pomocí klíčového slova pomocí ANY umožníme, aby element obsahoval libovolný obsah. Textový obsah elementu se definuje pomocí (#PCDATA). Element obsahující jiný element se definuje pomocí názvu vnořeného elementu uzavřeného v kulatých závorkách.
Element může obsahovat i více elementů, nebo kombinaci elementů a textového obsahu. Operátor čárky "," vytvoří sekvenci (zřetězení), operátor | vytvoří výběr jedné ze dvou variant. Operátor ? vyjadřuje nepovinný výskyt, operátor * libovolný počet výskytů (včetně žádného) a operátor + libovolný počet výskytů, nejméně však jeden. Vytvořené výrazy lze uzávorkovat pro změnu priority vykonávání operátorů.
V definici obsahu elementů záleží na pořadí jednotlivých částí definice. Pokud chceme dovolit libovolné pořadí elementů x a y, musíme použít zápis ((a,b)|(b,a)).
„(nazev, (autor|editor)?, p*, (nadpis,p+)*)“ vyjadřuje následující obsah: První je element název, po kterém nepovinně může následovat jeden ze dvou elementů autor nebo editor. Dále následuje libovolný počet (včetně žádného) elementů p Dále následuje.libovolný počet (včetně žádné) posloupností jednoho elementu nadpis a libovolného nenulového počtu elementů p.
2.1 Atributy
Atributy elementu lze definovat pomocí značky ATTLIST.
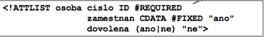
Na pořadí atributů v rámci elementu (na rozdíl od pořadí vnořených elementů) nezáleží. U jednotlivých atributů musíme uvést název a datový typ, můžeme nepovinně uvést požadavky na hodnotu atributu.
Datové typy atributů mohou být následující:
· CDATA – libovolný řetězec znaků
· Výčtový typ
· ID – jednoznačný identifikátor (v rámci dokumentu), musí to být řetězec písmen, cifer a znaků „-“, „_“, „:“, „.“, nejlépe v ASCII, musí začínat písmenem, nebo znakem „_“
· IDREF – odkaz na ID jiného elementu v rámci dokumentu
· IDREFS – seznam odkazů oddělených mezerami
· NMTOKEN – hodnota, tj. řetězec podobný jako ID, který ale může začínat cifrou a není jednoznačný
· NMTOKENS – hodnoty
· ENTITY – odkaz na externí entitu
· ENTITIES – seznam odkazů
Datový typ CDATA umožňuje uchovávat libovolný řetězec znaků.
Výčtový typ se definuje uvedením seznamu hodnot výčtového typu. Seznam hodnota je uzavřen v kulatých závorkách. Hodnoty jsou navzájem oddělené symbolem |. V našem příkladu je výčtového typu atribut dovolená s hodnotami ano a ne.
Datový typ ID lze použít pro atribut, jehož hodnota je unikátním identifikátorem v rámci dokumentu. Identifikátor musí začínat písmenem nebo znakem _, obsahovat může písmena, číslice a několik málo interpunkčních symbolů. V našem příkladu je tohoto typu atribut číslo.
Atribut datového typu IDREF má hodnotu obsahující odkaz na identifikátor ID jiného elementu. Hodnotou datového typu IDREFS je seznam identifikátorů ID oddělených mezerou.
Datový typ NMTOKEN je obdobou typu ID. Identifikátor, který může obsahovat, nemusí být unikátní a může začínat i číslicí. Datový typ NMTOKENS je obdobou typu IDREFS, ale místo seznamu identifikátorů ID obsahuje seznam identifikátorů NMTOKEN.
Na hodnoty atributů můžeme mít dodatečné požadavky. Pokud má být výskyt atributu povinný, uvedeme na konci jeho deklarace #REQUIRED. V našem příkladu se jedná o atribut číslo. Nepovinný atribut může (ale nemusí) být označen jako #IMPLIED. Atribut s konstantní hodnotou se označuje jako #FIXED, za tímto označením následuje povinná neměnná hodnota. V našem příkladu se jedná o atribut zaměstnán s implicitní hodnotou "ano".
2.2 Entity
Entita v XML dokumentu je identifikátor, který se používá uvozený symbolem & a zakončený středníkem. Entita v XML dokumentu zastupuje symbol (znakové entity) nebo řetězec znaků (obecné entity). V DTD mohou být definovány parametrické entity, které jsou uvozeny symbolem % a zakončeny středníkem.
Znakové entity slouží k nahrazení jednoho znaku. Využívají se obvykle pro znaky, které uvozují syntaktické konstrukce v XML a nelze je proto napsat přímo (&, <, >, ', "), protože parser by je chápal jako začátky těchto konstrukcí (např. & = amp, < = lt, > = gt). Například řešíme, jak nahradit matematický symbol < entitou. Symbol < nelze napsat přímo, parser by ho považoval za začátek elementu. Na výběr máme mezi jeho zápisem v desítkové či šestnáctkové soustavě < nebo použitím předdefinované entity pro speciální znaky <.
Obecné entity slouží k nahrazení opakující se částí XML dokumentu jedním identifikátorem (interní entity) nebo pro rozdělení jednoho XML dokumentu do více modulů (externí entity). Interní entita se definuje pomocí značky ENTITY následované identifikátorem entity a její hodnotou uzavřenou v uvozovkách. Externí entita se definuje pomocí značky ENTITY následované identifikátorem entity, klíčovým slovem SYSTEM a v uvozovkách uzavřeným názvem souboru, ve kterém se nachází obsah entity.
Na slajdu č. A/40 vidíme dva příklady definice obecných entit. V horním příkladu definujeme interní entitu stav, která je v XML dokumentu použita uvnitř elementu poznámka. V dolním příkladu definujeme externí entitu xml-seriál, její obsah se nalézá v souboru xml-seriál.txt.
Parametrické entity slouží v DTD k zpřehlednění a zkrácení jeho zápisu. Definují se obdobně jako interní entity, ale navíc je před jejich názvem uveden symbol %. Použít je lze pouze na jiném místě DTD, uvedením symbolu %, názvu entity a středníku. Na slajdu č. A/42 vidíme definici parametrické entity atributy, která je v příkladu použita na několika místech pro definici seznamu atributů různých elementů.
3. XML v SQL Serveru
Práce s XML v každém databázovém systému bývá řešena rozdílnými způsoby. My si v této kapitole popíšeme situaci v SQL Serveru 2005.
– CREATE TABLE XmlTab( ID NUMERIC
CONSTRAINT XmlTabPk PRIMARY KEY, Dok XML
);
– INSERT INTO XmlTab VALUES( 1, ’<a><b>b1</b></a>’
);
Toto je příklad, jak lze vytvořit tabulku obsahující sloupec (Dok) datového typu XML. Hodnotou sloupce Dok je celý XML dokument. Pomocí příkazu INSERT lze tabulku naplnit daty, hodnota (= XML dokument) vkládaná do sloupce Dok musí být v apostrofech.
Můžeme také naopak exportovat data z tabulek do formátu XML, dokonce můžeme exportovat i výsledek celého dotazu. Níže vidíme rozšířenou syntax příkazu SELECT, která umožňuje výsledek dotazu zobrazit jako XML dokument. Za příkaz SELECT se přidají klíčová slova FOR XML a jeden z následujících módů: RAW, AUTO, EXPLICIT nebo PATH. Například SELECT * FROM zákazník FOR XML AUTO exportuje do XML tabulku zákazník.
SELECT ... FOR XML {RAW|AUTO|EXPLICIT|PATH} [,XMLDATA][,ELEMENTS][BINARY BASE64] [ROOT(’korenovy_element’)]
Použití módu RAW pro každý řádek výsledku dotazu vytvoří samostatný element pojmenovaný row. Název elementu row lze změnit uvedením požadovaného názvu v apostrofech do závorky za klíčové slovo RAW. Například … FOR XML RAW ('řádek‘). Jednotlivé sloupce výsledku dotazu jsou atributy elementu a hodnoty sloupců jsou hodnotami těchto atributů.
RAW generuje pro každou řádku jeden element row, hodnoty jsou obsažené v atributech elementu, názvy atributů odpovídají názvům sloupců (aliasů) v dotaz
<row empno=”1230” ename=”King” deptno=”10” />
<row empno=”4560” ename=”Scott” deptno=”10” />
<row empno=”7800” ename=”King” deptno=”20” />
Použití módu AUTO pro každý řádek výsledku dotazu a pro každou použitou tabulku ve výsledku dotazu vytvoří samostatný element. Názvy elementů odpovídají názvům tabulek. Struktura zanoření elementů odpovídá pořadí spojení tabulek. Nejhlouběji zanořený element je ten, jehož tabulka je v klauzuli FROM uvedena jako poslední.
AUTO generuje pro každou tabulku v použitém dotazu jeden element. Struktura odpovídá spojení. Názvy elementů odpovídají názvům tabulek
<dept deptno=”10”>
<emp empno=”1230” ename=”King” />
<emp empno=”4560” ename=”Scott” />
</dept>
<dept deptno=”20”>
<emp empno=”7800” ename=”King” deptno=”20” />
</dept>
K oběma módům RAW a AUTO lze použít nepovinný modifikátor ELEMENTS, který ze sloupců výsledku dotazu vytvoří místo atributů samostatné podelementy. Modifikátor ELEMENTS se přidává za klíčová slovo AUTO nebo RAW a je od nich oddělen čárkou. Například … FOR XML AUTO, ELEMENTS.
Modifikátor ELEMENTS zajistí, že hodnoty atributů jsou uloženy jako podelementy, nikoli jako atributy
<dept>
<deptno>10</deptno>
<emp>
<empno>1230</empno>
<ename>King</ename>
<empno>4560</empno>
<ename>Scott</ename></emp>
</dept>
<dept deptno=”20”>
</dept>
Dalším užitečným modifikátorem je ROOT, za kterým je v závorce a apostrofech uvedeno jméno kořenového elementu, který bude obalovat všechny elementy vytvořené pro jednotlivé řádky výsledku dotazu. Tento modifikátor se odděluje od zbytku dotazu čárkou, obdobně jako modifikátor ELEMENTS. Například … FOR XML RAW, ROOT('kořen').
Níže vidíme jaké indexy lze vytvořit pro XML data. Pokud plánujeme v těchto datech často vyhledávat, je vytvoření těchto indexů nezbytné. Nejprve je nutné vytvořit primární XML index příkazem CREATE PRIMARY XML INDEX. Na slajdu nahoře tento index vytváříme a pojmenováváme XmlIdx. Následně s použitím tohoto indexu lze vytvořit tři samotné indexy: index cest (PATH), hodnot (VALUE) a vlastností (PROPERTY). Příklad je uveden v dolní části slajdu.
– Nejprve je nutné vytvořit primární XML index CREATE PRIMARY XML INDEX XmlIdx ON XmlTab(Dok)
– Následně lze vytvořit hodnotový index, index cest a index vlastností CREATE XML INDEX jm ON XmlTab(Dok) USING XML INDEX XmlIdx FOR {VALUE|PATH|PROPERTY}